ИТ-технологии для профессионалов

Показаны сообщения с ярлыком Hyper-V. Показать все сообщения

понедельник, 30 декабря 2013 г.

Failover Clustered Storage Spaces а-ля Cluster-in-a-box (проверка отказа ресурсов кластера в сценарии бюджетной СХД)


(Ликбеза по технологии Windows server 2012 - Storage Spaces, как настраивать и обзора всего того, что это может дать, в статье не будет. Кому интересно, все есть как на сайте разработчика ОС, так и других обзоров по Storage Spaces навалом)

Наверняка многие знают про новый функционал по работе с дисковой подсистемой появившейся в Windows Server 2012, а именно  Storage Spaces, позволяющий объединять диски с разными интерфейсами, в единый дисковый пул и дальнейшим созданием виртуальных дисков на этом пуле, с необходимым уровнем отказоустойчивости.
Так же не является секретом, то что Storage Spaces возможно кластеризовать и с точки зрения Microsoft , получить  не дорогое решение высоко доступного хранилища. Доступ к системе хранения может быть как файловый (CIFS, NFS, SMBScale-Out), так и блочный (iSCSI).

Ну что же, подумали мы, не плохо бы было проверить такое бюджетное решение на пригодность и поглядеть на отработку фэйловера.
Читать дальше ...

четверг, 7 октября 2010 г.

Семинар Тринити + Microsoft + Hyper-V

Мы рады пригласить Вас на семинар, проводимый  компаниями Microsoft и Тринити, посвященный теме:

«Построение систем высокой доступности»

Одна из основных задач IT – это повышение доступности сервисов, которые предоставляются пользователям. Данный круглый стол посвящен теме построению систем высокой доступности с помощью технологий виртуализации компании Microsoft и ее партнеров.  В рамках семинара будут рассмотрены как решения Microsoft, так и сторонние прикладные решения, расширяющие их функционал.

Мероприятие состоится 19 октября - (с 09:30-13:00) по адресу ул. Крылатская, д.17, корп. 1., бизнес центр «Крылатские холмы»

Программа:

09:30 – 10:00    Утренний кофе, регистрация
10:00 – 11:30    Как построить систему высокой доступности и нужна ли для этого виртуализация?
11:30 – 12:00    Перерыв на кофе
12:00 – 13:00    Средства повышения доступности приложений в виртуальной среде Microsoft Hyper-V

Будем рады видеть Вас!

Участие в семинаре бесплатное, просьба для регистрации направить письмо по адресу s.sosunova@trinitygroup.ru.

Читать дальше ...

пятница, 9 июля 2010 г.

Сказка перед выходными

История придуманная и любые совпадения с реальными персонажами являются случайными (хотя и вполне вероятными).
Жил да был системный администратор, работал себе в небольшой компании, серверов у него в услужении было всего ничего – ну пусть будет 4 штуки, скажем. На серверах все стандартно, везде Windows Server  установлен да и приложения на нем всякие работают – и контроллер домена, и файловый сервер, и почта, и SQL тоже был.
imageЖил бы наш админ, да и горя бы не знал, только как случись какая неполадка в его хозяйстве, так сразу его под белы рученьки на ковер к начальству ведут и ругают на чем свет стоит. А он, бедный, только руками разводит да слезно просит бюджет увеличить, чтобы большую СХД купить – без нее никак у него не получится все задачи в виртуальную инфраструктуру перевести, обеспечив тем самым большую отказоустойчивость. Начальство же ему в ответ, хмуря брови - “Нет! Тебе лишь бы деньги казенные в расход пустить! Мы вон тебе серверов купили отличных уже недавно! А нагрузка, сам говоришь, процентов 10 от силы. Да как у тебя язык-то поворачивается о таком просить?! Кризис же на дворе! Поди прочь, с глаз долой и сделай срочно, чтобы все работало!”.
И после таких разговоров шел обычно админ, понурив голову, к себе в кабинет и думку думал, но решение никак не приходило. Он уже и прикинул, какая производительность для текущих задач нужна – действительно, если Hyper-V использовать, то и пары физических серверов хватит. Но все равно – нужен внешний сторадж, чтобы хранить данные виртуальных машин. Можно конечно на “лишнем” сервере сделать iSCSI target (благо вариантов таких полно сейчас, даже и бесплатных). Но что будет, если это сервер “рухнет”?! Тогда уж сразу можно заявление на стол, а голову в петлю. Резервные копии на второй сервер немного подсластят жизнь, да только остановка сервисов при сбое все равно будет слишком долгая. Как же быть?
И вдруг вспомнил админ, что совсем недавно читал в каком-то блоге :) про Sanbolic Melio 2010. Есть же там и специальная редакция для Hyper-V, цена которой начальство ну никак не расстроит! И поддержка iSCSI есть, и кластерная файловая система все проблемы с CSV томами снимет. Так может быть можно и два iSCSI хранилища в “зеркало” объединить, чтобы защититься от сбоев? А ведь и правда можно (в DataCenter версии Melio Suite)! Тут уж и работа закипела, освободил админ два сервера, настроил на внутренних дисках RAIDы, установил iSCSI target, настроил все. Поставил на серверы с Hyper-V Sanbolic Melio 2010 (покупать сразу не решился, поэтому получил сначала демо-версию, которая по функционалу от оплачиваемой и не отличается ничем, кроме ограничения на срок использования).  Создал зеркало, отформатировал диски – и все!
image После этого сбой любого из серверов Hyper-V приводил только к перезапуску виртуальных машин на “живом” сервере, а если использовать DataCenter редакцию Melio, то и сбой сервера iSCSI вообще никак на доступности сервисов не отражается – вторая половина зеркала берет всю нагрузку на себя.
И вот тут-то админ и понял, что значит завоевать уважение и благосклонность начальства – бюджет решения был минимизирован, имеющееся оборудование было полностью задействовано, отказоустойчивость повысилась многократно. Теперь можно и в отпуск отпроситься, не опасаясь что через два дня срочно вызовут, да и обругают за то что ничего не работает.
Вот такая вот сказка получилась. Правдивая? По моему мнению - более чем! Читать дальше ...

четверг, 29 апреля 2010 г.

Копирование файлов на CSV диск

В весьма полезном блоге про технологии виртуализации Mirosoft вчера появился очередной пост, на этот раз посвященный копированию файлов на тома CSV. При копировании файла на общий кластерный ресурс (CSV диск) на различных узлах скорость очень сильно отличается. Причина в том, что если узел, на котором происходит копирование, является координатором тома CSV, все операции происходят локально и скорость максимальная. Если же узел координатором не является, то все операции записи перенаправляются на узел-координатор по сети. Конечно же такая проблема наблюдается только при копировании файлов – когда виртуальная машина работает со своим VHD файлом, все операции уже идут исключительно “напрямую”. Соответственно, чтобы минимизировать нагрузку, нужно сначала найти узел-владелец кластерного ресурса (либо через консоль Failover Cluster Manager, либо через powershell), а уже потом именно на этом узле произвести все необходимые операции с файлами. Но есть и другой выход! Я уже писал про него ранее – это кластерная файловая система Sanbolic MelioFS. image При ее использовании все узлы имеют параллельный доступ к общему диску. Производительность уже совершенно не зависит от того, на каком узле мы осуществляем те или иные операции с файлами. “Младший” по функционалу бандл (и, что для многих весьма немаловажно,  самый бюджетный) - Melio Virtualization Product Suite как раз и предназначен специально (и только) для хранения файлов виртуальных машин (как раз там и используются CSV тома, когда нет кластерной файловой системы). Помимо непосредственно файловой системы (которая кстати поддерживает и VSS), в состав пакета входит менеджер томов LaScala и средство для автоматической миграции файлов SILM. С помощью SILM можно переносить неиспользуемые данные на вторичное хранилище (на нем, при этом, вовсе не обязательно должна быть файловая система MelioFS). Общие диски могут быть подключены к серверам как по FibreChannel, так и по iSCSI (фактически не выдвигаются никакие дополнительные требования по сравнению с теми, которые есть при использовании CSV).

Читать дальше ...

среда, 13 января 2010 г.

Общий доступ к дискам (Sanbolic Melio FS и другие)

С завидным постоянством вижу вот такого плана вопрос:

“Мы установили дисковую систему, создали один LUN, все настроили, подключили два сервера. На одном сервере файлы записываем, а на другом никаких изменений не видно. Да еще и ошибки какие-то странные. Что надо еще настраивать?”.

Причем, как это ни странно, технический уровень спрашивающих может быть очень разным, а вопрос один и тот же. А ведь, казалось бы, все очевидно: файловые системы (большинство), которые мы привыкли использовать (NTFS, EXT3, …) просто не умеют работать в таком “распределенном” режиме. Представьте, что на сервер А мы записали на диск файл, но каким образом об этом станет известно серверу B? Без специальной кластерной файловой системы, которая сообщит ему об этом – никак. И наиболее вероятным результатом (даже сравнительно короткого) такого “испытания” на обычной файловой системе будет полный ее крах. Поэтому даже и эксперименты проводить не стоит – работать не будет! А что тогда делать и нужно ли это вообще? В большинстве случаев (особенно если очень пристально посмотреть на задачу или заказчика :) ) такой функционал действительно оказывается ненужным и для совместного доступа к файлам достаточно использовать CIFS (в Windows) или NFS (в Linux). Но, тем не менее, существует и довольно много задач, где общий доступ к дисковому устройству если и не необходим, то очень важен. Как для более простой реализации, так и для лучшей производительности системы. Для того чтобы такой доступ обеспечить нам и  нужна будет кластерная файловая система. Существует их довольно много, подавляющее большинство ориентировано на Linux/Unix (RedHat GFS, IBM GPFS, Lustre, HP Plyserve и т.п.), но и Windows не остался в стороне (Sanbolic MelioFS, HP Polyserve, IBM GPFS). Исторически решения под Linux использовались для HPC кластеров (и ряда других приложений), а под Windows в основном для обработки медиа-контента. Сейчас дисбаланс уже не так заметен – Windows работает на всех фронтах. Кроме того, все активнее внедряются системы виртуализации на базе Hyper-V в Windows Server 2008 и 2008 R2. И, если у основного конкурента (VMware) кластерная файловая система уже есть (VMFS), то в случае с Hyper-V нужно либо обходиться без нее, либо использовать сторонние продукты. Но даже и в случае с VMware разделяемая файловая система может очень пригодиться – например при использовании совместно с бесплатным VMware Server можно размещать образы виртуальных машин на общем дисковом ресурсе, что значительно упрощает миграцию и в разы снижает время простоя при сбоях.

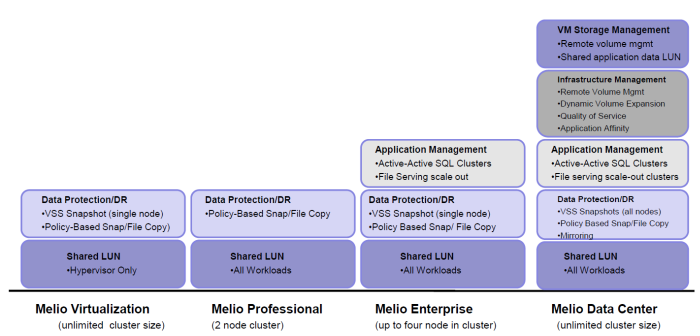
Сегодня более подробно я остановлюсь на решениях компании Sanbolic. Помимо кластерной файловой системы MelioFS, в портфель продуктов постепенно добавлялись и другие решения – это и система управления томами LaScala, и SILM, и AppCluster (о них немного ниже), а выбрать что же именно нужно купить, чтобы получить искомый результат, становилось все сложнее. И, если представители интегратора в большинстве случаев хорошо понимают что и для чего нужно, то объяснить клиенту, что ему нужна не одна лицензия за 2000$, но к ней еще нужно докупить две лицензии по 1500$, было в некоторых случаях сложно. В настоящее время ситуация существенно упростилась и предлагается всего 4 лицензии: Melio Virtualization, Melio Professional, Melio Enterprise и Melio Data Center. Благодаря этому выбор оптимального решения стал гораздо проще.
image

Все четыре продукта включают в себя (помимо кластерной файловой системы) систему управления томами (volume manager) LaScala. Поддержка страйпинга и конкатенации позволяет получить высокопроизводительный том необходимого объема. Также во все бандлы входит система SILM (Simple Information Lifecycle Manager), которая, на основе заданных пользователем политик, может перемещать файлы между различными системами хранения. Например, файлы, к которым не было обращения более 10 дней, будут перенесены на более медленную дисковую систему. Важно отметить, что поддерживается “смешанный” режим работы – данные могут располагаться не только на томах MelioFS, но и на любых других дисках (в том числе и локальных).

Melio Virtualization ориентирован на заказчиков, которые внедряют у себя Hyper-V или VMware Server, и позволяет получить всем серверам доступ к общей дисковой подсистеме (iSCSI или FC) для размещения на ней образов виртуальных машин. Благодаря поддержке технологий Quick и Live Migration, а также отсутствию ограничения на число серверов в кластере, актуальность данного решения фактически прямо пропорциональна числу физических серверов Hyper-V.

Второй, ориентированный на виртуализацию продукт - Melio Professional. Он предназначен для развертывания отказоустойчивого высокопроизводительного кластера системы динамической загрузки образов операционных систем на базе Citrix Provisioning Services. На общей файловой системе хранится как база данных, так и сами vDisk вместе с файлами кэшей записи. Нужно помнить, что данный бандл имеет ограничение на включение максимум двух узлов в кластер (а использовать меньше и смысла не имеет).

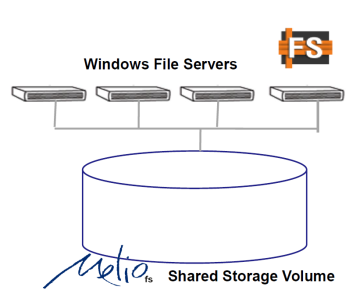
Два оставшиеся варианта лицензий уже не являются такими узкоспециализированными и предназначены для широкого круга заказчиков, чьи задачи не ограничиваются только виртуализацией. Melio Enterprise поддерживает совместную работу до 4х узлов в одном кластере и имеет ряд ограничений по сравнению с “топовой” версией Melio Data Center. В частности, нет поддержки зеркалирования (RAID1) и Quality of Service. Обе версии позволяют создавать высокопроизводительные кластеры файловых серверов, в том числе и с поддержкой балансировки нагрузки (NLB). Разумеется поддерживается DFS и ACL. Возможность динамического расширения файловой системы и томов позволяет избежать лишних остановок сервиса для обслуживания системы. По мере роста требований к файловым серверам можно добавлять как серверы, так и системы хранения в существующий кластер, увеличивая тем самым как суммарную емкость, так и производительность системы в целом:
image

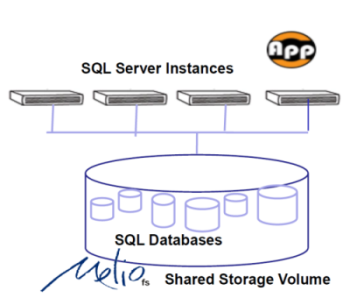
Также в состав обоих пакетов входит AppCluster Manager – средство управления active-active кластерами MS SQL, когда соответствующие базы данных размещены на разделяемой файловой системе. Конечно, это решение не позволяет (в силу архитектуры MS SQL) построить аналог Oracle RAC, но дает возможность обеспечить минимальное время переключения между серверами в кластере в случае сбоя, а также балансировать нагрузку между физическими машинами:imageВ варианте Data Center AppCluster работает совместно с QoS, чтобы позволяя критичным базам иметь приоритет при работе с дисковыми ресурсами.
Для тех же кто использует Hyper-V есть еще зачастую весьма веская причина использования Enterprise или Datacenter версий – технология Pass-through I/O увеличивает производительность дисковой подсистемы так как не требуется оповещение остальных машин в Windows Failover кластере об операциях записи в виртуальных машинах.

Триальную двухнедельную версию можно получить, зарегистрировавшись на сайте Sanbolic. А купить и/или получить более подробную информацию, как обычно, можно у нас. :)

Читать дальше ...

четверг, 1 октября 2009 г.

Достоинства Microsoft Hyper-V

Некоторое время назад я писал про недостатки MS Hper-v с которыми я столкнулся в практическом внедрении. Прочтя тот текст могло сложиться впечатление, что продукт вообще не нужный и ни к чему не подходит, но это не так.

В действительности продукт имеет свою рыночную нишу и прекрасно себя в ней чувствует. В этом тексте я постараюсь подробнее остановиться на преимуществах продукта и как следствие ситуациях в которых его выгодно использовать.

1. Это виртуализация от Microsoft и она работает! Как это не смешно звучит, но это очень сильный аргумент и из него вытекают многие другие  аргументы ниже.

2. Ядро системы базируется на Windows Server. В результате администраторам, которые исторически работают только с системами Microsoft, нет необходимости изучать Unix. Все же полноценное администрирование VMware без знания RedHat Linux невозможно. Самый просто пример – установка драйвера устройства отсутствующего в системе.

3. Продукт имеет встроенный функционал по обеспечению отказоустойчивости реализованный с помощью Failover Cluster. Что любопытно, имеют право на жизнь конфигурации в которых узлы кластера, кроме виртуальных машин поддерживают отказоустойчивость других сервисов. К примеру, это может быть кластер из двух серверов поддерживающий SQL, а до кучи на нем может работать 2-3 виртуальных машины. В случае если производительности хватит на всех, это на 100% рабочая конфигурация.

Опять же немаловажно, что для техников уже работавших с Microsoft Failover Cluster кластеризация виртуальных машин будет таким же привычным делом как кластеризация файловой шары.

4. Система очень неприхотлива к оборудованию на котором она работает. Есть конечно жесткое требование по обязательной поддержке технологий Intel-VT или AMD-V процессорами в системе, но за исключением этого,система работает на любой платформе. Всё же системы Windows, чрезвычайно распространены в мире и количество драйверов под них не поддается исчислению.

5. Если рассматривать вариант лицензирования отказоустойчивого кластера Hyper-V, для которого требуется минимум две лицензии на Windows Server Enterprise Edition, то эти две лицензии также позволяют запустить 4 виртуальные машины с ОС Windows Server в виртуальной среде. В ситуации когда в компании работают только Windows это вполне актуально, при определенных расчетах может получиться так что сам Hyper-V вам достается бесплатно.

6. Hyper-V комфортно управляется средствами продуктов Microsoft System Center. С их помощью он умеет отправлять сообщения о проблемах, проводить резервное копирование, мониторить производительность, детально управлять обновлениями. Что приятно есть лицензия на SystemCenter для серверов, которая лицензирует все виртуальные машины физического сервера, на все компоненты SystemCenter.

7. В Hyper-V нормально реализована система сетевого подключения для виртуальных машин. Есть VLan, есть возможность надобавлять кучу разных сетевых карт. Конечно по сравнению с другими производителями это смотрится бедненько, но с другой стороны что еще надо?


В результате я вижу что заказчики имеющие чисто Microsoft среды с настроенным и работающим SystemCenter, остаются довольны продуктом. Он удовлетворяет все их потребности, не заставляя вносить в свою “исключительно MS” инфраструктуру чужеродные элементы, которые еще надо кому-то поддерживать. Опять же зачастую использование Hyper-V совпадает в таких ситуациях с лицензированием нелегальных Windows Server, что фактически означает что стоимость Windows 2008 EE уходит не только на сам Hyper-V, но и на легализацию существующих Windows.

Читать дальше ...

четверг, 30 июля 2009 г.

Отказоустойчивость сетевых подключений в Windows 2008 server и Hyper-V

Для обеспечения отказоустойчивости сети, наиболее понятный путь – объединение нескольких интерфейсов в одну группу, в Linux  эта процедура называется бондинг, в Windows эта функция не заложена в ОС и требует дополнительных компонент для своей работы, компоненты эти предоставляются производителями сетевых карт. Соответственно сколько производителей сетевых карт, столько технологий объединения. Для меня представляет определенный интерес сетевые адаптеры broadcom, поскольку именно их встраивают в свои сервера все основные вендоры: IBM, HP, Dell, Fuji. Встраивают в основном карты NetXtreme I или II. Понятно что при необходимости можно добавить карты Intel, но зачастую это не позволяет сделать конструктив, к примеру в Blade системах, либо в другой ситуации оказываешься перед фактом – есть то железо которое есть. Как известно добавляют сетевые карты в сервера сверх встроенных – нечасто.

Итак о какой задаче пойдет речь – необходимо реализовать полную отказоустойчивость сервера на уровне локальной сети - 1GB Ethernet. При том, что сервер работает в кластере и используется для работы Microsoft hyper-v.

Зачем нужна отказоустойчивость сети

Сначала надо понять надо ли это, я постараюсь описать здесь свою позицию. Первая причина для перевода серверов в виртуальную среду – консолидация нагрузки на одном сервере для более эффективного использования его ресурсов. Из этого напрямую следует потребность повышения надежности данного сервера, ведь на нем работает не один сервис а несколько, к тому же еще и разные по своей сути. То есть падение сервера с разнородной нагрузкой скорее всего повлияет на разные группы пользователей, но на всех критически.

По большому счету платформа виртуализации представляет собой 3 больших блока – вычислительная часть, сетевая (I/O) и система хранения данных для виртуальных машин. Отказоустойчивость для вычислительной части на 100% процентов для х86 систем невозможна, к ней можно приблизиться путем создания Failover Cluster в Microsoft. С точки зрения отказоустойчивости системы хранения можно отметить что, отказоустойчивость самой системы рационально реализовать с помощью надежного конструктива собственно СХД и дублирования её компонент, к Microsoft и операционной системе это отношения не имеет. Отказоустойчивость путей подключения сервера к СХД реализуется с помощью встроенного в Windows 2008 MPIO либо с помощью ПО производителя СХД, тут тоже все работает без каких либо сложностей. Остается отказоустойчивость сети. Как я писал выше единственно возможный путь здесь – объединение карточек в одну группу и настройка отказоустойчивости канала в этой группе. В системах виртуализации Vmware и Citrix это встроенный функционал реализованный внутри самой системы, в Microsoft Hyper-V необходимо использовать сторонний софт. Как я писал выше я пытаюсь реализовать эту схему на сетевых картах Broadcom.

Реализация Broadcom

В ПО предлагаемом Broadcom есть 3 варианта организации Teaming:
1. Проприетарный вариант имени Broadcom. (называется - “SLB”)
2. LACP 802.11 ad
3. Generic Trunking

Несколько слов о том чем они отличаются:
1. Работает на уровне драйвера, поддержки от коммутатора не требует. теоретически в настройках есть два режима – балансировка и отказоустойчивость.
2. Требует поддержки от свитча соответствующей технологии.
3. Похоже на второй вариант, отличается жесткой организацией транка. (Более подробно в документации)

Надо сказать что независимо от того какой вариант будем собирать, я отключаю все расширенные настройки в свойствах сетевой карты с помощью утилиты от Broadcom - BACS, через эту же утилиту и настраивается тиминг.

image
Настройки сетевой карты. В общем случае должно быть все также, только Locally Administered Address будет пустой. Это скриншот с уже собранного тиминга.

Первичная проверка и способ тестирования работы

Итак, чтобы с чего то можно было начать, был сделан самый просто вариант тиминга SLB из двух сетевых карт одна из которых была в режиме standby. То есть был собран самый просто режим отказоустойчивости. Эта процедура была проведена на двух серверах на которых стояла ОС w2008 server SP2 ent x64, на этих серверах был настроен hyper-v и оба они были в составе одного Failover Cluster. В кластере было 3 виртуальные машины, одна с домен контроллером для кластера и две с установленной 2008 Windows в качестве демо нагрузки. В обоих узлах кластера было по две сетевые карты broadcom BCM5708S NetExtreme II, версия драйвера 4.8.5.0, версия прошивки 4.6.0 на момент проверок это были наиболее актуальные версии взятые с сайта производителя.

Проверка осуществлялась следующим образом – на каждой из двух демо машин создавался скрипт с одной строкой “shutdown –s –t 40” этот скрипт ставился на выполнение после загрузки ОС на каждой виртуальной машине. Естественно обе машины были в кластере.

Что получалось таким образом? Виртуальная машина включалась, грузилась, а через 40 секунд выключалась. Кластерный сервис воспринимал это как аварию и включал эту виртуальную машину на другом сервере. Там происходило все с самого начала и машина опять выключалась.

Почему выбирался такой странный способ проверки? Я убедился в работоспособности этого тиминга с Hyper-v и на обычной нагрузке поэтому в принципиальной возможности работы такой схемы у меня сомнений нет. Я делал подобный вышеописанному тест на кластере без тиминга и он тоже спокойно работал, то есть система переключала виртуальные машинки с одного сервера на другой несколько дней без сбоев. В конфигурации же с тимингом и кластером работающим через интерфейсы входящие в тиминг могут возникнуть отдельные сложности.

Да, надо сказать о настройке самого кластера – в нем два узла-сервера, находящихся в одной подсети. В  качестве внешнего стораджа используется FC система, на ней хранятся виртуальные машины и кворум кластера. В кластере используется одна сеть вида 192.168.199.0/24 в этой подсети и находятся оба узла. Использование этой сети для кластера – разрешено. Режим работы кластера – “Node and Disk Majority”.

Результат первой проверки

После порядка 40 переключений ВМ, или около часа времени постоянных переключений виртуальных машин один из узлов вылетел в BSOD. В результате образовался minidump который был разобран и получен следующий результат:

C:\Users\admin\Desktop\kdfe>kdfe.cmd "teaming BASP Mini072909-01.dmp"
Analyzing "C:\Users\admin\Desktop\kdfe\teaming BASP Mini072909-01.dmp", please wait... Done.

Crash date:         Wed Jul 29 17:54:58.282 2009 (GMT+4)
Stop error code:    0x7f_8
Process name:       System
Probably caused by: NETIO.SYS ( NETIOMatchValues+14e )

Эта стоп ошибка – описана в KB842465 если коротко – ошибка вычислений CPU. По большому счету показывает что произошла критическая ошибка в вычислениях.

Затем было произведено переконфигурение тиминга в режим LACP, сделаны нужные настройки на свитче куда включались интерфейсы и повторен тест, система упала в BSOD еще быстрее в результате был получен следующий minidump:

C:\Users\admin\Desktop\kdfe>kdfe.cmd LACP_Mini073009-05.dmp
Analyzing "C:\Users\admin\Desktop\kdfe\LACP_Mini073009-05.dmp", please wait... Done.

Crash date:         Thu Jul 30 14:01:32.501 2009 (GMT+4)
Stop error code:    0x7f_8
Process name:       System
Probably caused by: NETIO.SYS ( NETIOMatchValues+14e )

ошибка полностью повторяет первую.

Здесь я чуть позже размещу ссылки на описание этой утилиты и её возможностей, а в следующем посте опишу свои злоключения с ней.

Читать дальше ...

вторник, 23 июня 2009 г.

Недостатки Hyper-V

Родился данный текст как результат внедрения продукта в большом объеме и в связи со многими технологиями от MS участвующими в этом же проекте.

итак по порядку

1. отсутствие нормально реализованного teaming для сетевых карт, существующий вариант от broadcom требует донастройки и “из коробки” не работает. Если же у нас узлы hyper-v еще и в кластере – то конфигурация становится невалидной, т.к. использовать на кластерных интерфейсах teaming низя по докам от MS. Т.е. нужно либо больше 2-х интерфейсов либо отказаться от teaming.

2. Необходимо выверять все драйвера для железной платформы. при большом количестве и требования к полному единообразию, это требует напряжения.

3. Огромное количество патчей. Часть из патчей не полностью валидировано поддержкой. Я прихожу к выводу что человек который поддерживает большую ферму hyper-v вынужден очень хорошо уметь контролировать апдейты. Поскольку не все апдейты идут через WSUS это приходится делать вручную. Немаловажно что приходится периодически для апдейтов машинки перегружать.

4. Отсутствие живых миграций. Это конечно не самый важный минус, но учитывая необходимость перегружать сервера после апдейтов периодически это нехороший момент. Да, после релиза 2008R2 лично я его не буду использовать минимум пол года.

5. Отсутствие возможности детализировать приоритеты по сети, дискам. То что есть, сделано на зачаточном уровне и в реальности сложно используемо.

6. Отсутствие поддержки FC устройств внутрь ВМ.

7. Невозможность сделать Failover Cluster между ВМ без iSCSI. Таким образом получается что приходится делать устойчивый iSCSI таргет, т.е. это либо дисковая с 2-мя контроллерами либо еще один кластер, таким образом чисто между ВМ его не сделать.

8. Сложность мониторинга состояния системы и отсылки простых оповещений. Понятно что это достигается средствами SyscOM, но ИМХО сложность продукта сравнима со сложностью самого hyper-v. В итоге получается, что для мониторинга только hyper-v приходится осваивать универсальный инструмент связанный с SQL и т.д.

9. Сложность отладки нештатных ситуаций. Есть ряд ситуаций в которых отладка может быть крайне геморройным занятием. Самое неприятное в том, что ситуация обычна для всех сложных ошибок. т.е. получается что как сложная ошибка – так сразу неприятности.

10. Меньшее количество протестированного оборудования под платформу. Получается что широта поддержки оборудования бьет обратно тем что за такой широтой сложно присматривать.

11. Невозможность добавить в существующую виртуальную сеть более одного физического адаптера с каждого хоста. См выше про teaming.

буду стараться дополнять при возможности, сейчас больше ничего в голову не лезет

Читать дальше ...