ИТ-технологии для профессионалов

четверг, 14 января 2010 г.

Еще один игрок на рынке NAS

Infortrend, как и обещал, официально анонсировал свой выход на рынок сетевых систем хранения данных (NAS). Для начала выпущены 3 модели. Все они поддерживают доступ по протоколам CIFS, NFS, HTTP, FTP и iSCSI; имеют весьма объемный список поддерживаемых ОС; на них можно включить компрессию данных на дисках; мгновенные снимки позволят упростить резервное копирование, а репликация защитит данные от потери в критических ситуациях. Разумеется, поддерживаются всевозможные уровни RAID (все, что умеют обычные их дисковые системы). Диски можно использовать SAS (300GB и 450GB) или SATA (1TB).

  • EonNAS 3200 – модель начального уровня, оснащена двумя 1Гбит сетевыми портами и имеет 4ГБ кэша. В базовом варианте вмещает в себя до 12ти дисков, а расширяться умеет до 60ти дисков (по 12 дисков в специальном модуле расширения).

image

  • EonNAS 5100N и 5100U – более функциональные системы “постарше”. Они даже в базе уже состоят из двух модулей – непосредственно “головы” и дискового модуля на 12 дисков. “Наружу” имеется 4 x 1Gbit сетевых порта, а для 5100U еще и два 8Gbit порта Fibre Channel, максимальный объем кэша составляет уже 12ГБ. Максимальное число дисков составляет уже 84. Помимо тех возможностей, которые есть в модели 3200, в системах 5100 также присутствует thin provisioning (выделение дискового пространства по мере реальной необходимости). Производительность системы можно повысить еще и за счет использования двух SSD дисков оъемом 32ГБ или 64ГБ. И, как уже написано выше, для 5100U можно использовать еще и FC для подключения серверов, что дает возможность строить самые разные решения на базе систем EonNAS.

image
Узнав о готовящемся анонсе я, признаться, опасался того что будет выпущена система с двумя контроллерами и “перегруженная” возможностями. А это сделает ее совершенно неинтересной из-за попыток прыгнуть выше головы и конкурировать с NetApp и т.п. Однако, все обошлось и получилась довольно типичная для Infortrend “боевая лошадка”.
Читать дальше ...

среда, 13 января 2010 г.

Общий доступ к дискам (Sanbolic Melio FS и другие)

С завидным постоянством вижу вот такого плана вопрос:

“Мы установили дисковую систему, создали один LUN, все настроили, подключили два сервера. На одном сервере файлы записываем, а на другом никаких изменений не видно. Да еще и ошибки какие-то странные. Что надо еще настраивать?”.

Причем, как это ни странно, технический уровень спрашивающих может быть очень разным, а вопрос один и тот же. А ведь, казалось бы, все очевидно: файловые системы (большинство), которые мы привыкли использовать (NTFS, EXT3, …) просто не умеют работать в таком “распределенном” режиме. Представьте, что на сервер А мы записали на диск файл, но каким образом об этом станет известно серверу B? Без специальной кластерной файловой системы, которая сообщит ему об этом – никак. И наиболее вероятным результатом (даже сравнительно короткого) такого “испытания” на обычной файловой системе будет полный ее крах. Поэтому даже и эксперименты проводить не стоит – работать не будет! А что тогда делать и нужно ли это вообще? В большинстве случаев (особенно если очень пристально посмотреть на задачу или заказчика :) ) такой функционал действительно оказывается ненужным и для совместного доступа к файлам достаточно использовать CIFS (в Windows) или NFS (в Linux). Но, тем не менее, существует и довольно много задач, где общий доступ к дисковому устройству если и не необходим, то очень важен. Как для более простой реализации, так и для лучшей производительности системы. Для того чтобы такой доступ обеспечить нам и  нужна будет кластерная файловая система. Существует их довольно много, подавляющее большинство ориентировано на Linux/Unix (RedHat GFS, IBM GPFS, Lustre, HP Plyserve и т.п.), но и Windows не остался в стороне (Sanbolic MelioFS, HP Polyserve, IBM GPFS). Исторически решения под Linux использовались для HPC кластеров (и ряда других приложений), а под Windows в основном для обработки медиа-контента. Сейчас дисбаланс уже не так заметен – Windows работает на всех фронтах. Кроме того, все активнее внедряются системы виртуализации на базе Hyper-V в Windows Server 2008 и 2008 R2. И, если у основного конкурента (VMware) кластерная файловая система уже есть (VMFS), то в случае с Hyper-V нужно либо обходиться без нее, либо использовать сторонние продукты. Но даже и в случае с VMware разделяемая файловая система может очень пригодиться – например при использовании совместно с бесплатным VMware Server можно размещать образы виртуальных машин на общем дисковом ресурсе, что значительно упрощает миграцию и в разы снижает время простоя при сбоях.

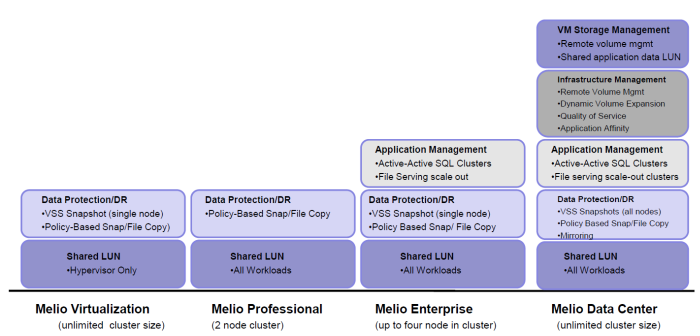
Сегодня более подробно я остановлюсь на решениях компании Sanbolic. Помимо кластерной файловой системы MelioFS, в портфель продуктов постепенно добавлялись и другие решения – это и система управления томами LaScala, и SILM, и AppCluster (о них немного ниже), а выбрать что же именно нужно купить, чтобы получить искомый результат, становилось все сложнее. И, если представители интегратора в большинстве случаев хорошо понимают что и для чего нужно, то объяснить клиенту, что ему нужна не одна лицензия за 2000$, но к ней еще нужно докупить две лицензии по 1500$, было в некоторых случаях сложно. В настоящее время ситуация существенно упростилась и предлагается всего 4 лицензии: Melio Virtualization, Melio Professional, Melio Enterprise и Melio Data Center. Благодаря этому выбор оптимального решения стал гораздо проще.
image

Все четыре продукта включают в себя (помимо кластерной файловой системы) систему управления томами (volume manager) LaScala. Поддержка страйпинга и конкатенации позволяет получить высокопроизводительный том необходимого объема. Также во все бандлы входит система SILM (Simple Information Lifecycle Manager), которая, на основе заданных пользователем политик, может перемещать файлы между различными системами хранения. Например, файлы, к которым не было обращения более 10 дней, будут перенесены на более медленную дисковую систему. Важно отметить, что поддерживается “смешанный” режим работы – данные могут располагаться не только на томах MelioFS, но и на любых других дисках (в том числе и локальных).

Melio Virtualization ориентирован на заказчиков, которые внедряют у себя Hyper-V или VMware Server, и позволяет получить всем серверам доступ к общей дисковой подсистеме (iSCSI или FC) для размещения на ней образов виртуальных машин. Благодаря поддержке технологий Quick и Live Migration, а также отсутствию ограничения на число серверов в кластере, актуальность данного решения фактически прямо пропорциональна числу физических серверов Hyper-V.

Второй, ориентированный на виртуализацию продукт - Melio Professional. Он предназначен для развертывания отказоустойчивого высокопроизводительного кластера системы динамической загрузки образов операционных систем на базе Citrix Provisioning Services. На общей файловой системе хранится как база данных, так и сами vDisk вместе с файлами кэшей записи. Нужно помнить, что данный бандл имеет ограничение на включение максимум двух узлов в кластер (а использовать меньше и смысла не имеет).

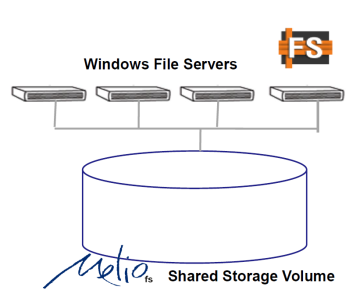
Два оставшиеся варианта лицензий уже не являются такими узкоспециализированными и предназначены для широкого круга заказчиков, чьи задачи не ограничиваются только виртуализацией. Melio Enterprise поддерживает совместную работу до 4х узлов в одном кластере и имеет ряд ограничений по сравнению с “топовой” версией Melio Data Center. В частности, нет поддержки зеркалирования (RAID1) и Quality of Service. Обе версии позволяют создавать высокопроизводительные кластеры файловых серверов, в том числе и с поддержкой балансировки нагрузки (NLB). Разумеется поддерживается DFS и ACL. Возможность динамического расширения файловой системы и томов позволяет избежать лишних остановок сервиса для обслуживания системы. По мере роста требований к файловым серверам можно добавлять как серверы, так и системы хранения в существующий кластер, увеличивая тем самым как суммарную емкость, так и производительность системы в целом:
image

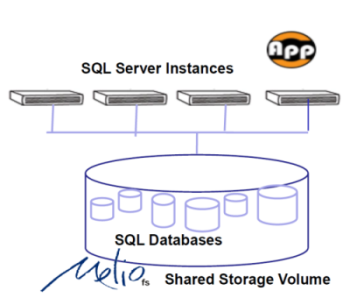
Также в состав обоих пакетов входит AppCluster Manager – средство управления active-active кластерами MS SQL, когда соответствующие базы данных размещены на разделяемой файловой системе. Конечно, это решение не позволяет (в силу архитектуры MS SQL) построить аналог Oracle RAC, но дает возможность обеспечить минимальное время переключения между серверами в кластере в случае сбоя, а также балансировать нагрузку между физическими машинами:imageВ варианте Data Center AppCluster работает совместно с QoS, чтобы позволяя критичным базам иметь приоритет при работе с дисковыми ресурсами.
Для тех же кто использует Hyper-V есть еще зачастую весьма веская причина использования Enterprise или Datacenter версий – технология Pass-through I/O увеличивает производительность дисковой подсистемы так как не требуется оповещение остальных машин в Windows Failover кластере об операциях записи в виртуальных машинах.

Триальную двухнедельную версию можно получить, зарегистрировавшись на сайте Sanbolic. А купить и/или получить более подробную информацию, как обычно, можно у нас. :)

Читать дальше ...

пятница, 8 января 2010 г.

Апдейты для дисковых систем Xyratex

Во первых строках хочу поздравить всех Вас с наступившим уже наконец Новым Годом и пожелать всевозможных успехов и конечно же достижения поставленных перед собой целей!

Праздники подходят к финалу и Xyratex выпустил долгожданную прошивку за номером 2.5.6 для систем E5412E, F5412E, F6412E и F5404E. “Долгожданную” – так как именно в ней появилась поддержка 2ТБ дисков (Hitachi HUA722020ALA330). И теперь можно получить до 120ТБ raw пространства на системах 5412 и 6412 и целых 192ТБ на системе F5404E. Причем, в последнем случае, это потребует только лишь в 8U в стандартной 19” стойке. Разумеется, помимо поддержки 2ТБ дисков в прошивку вошли различные исправления (в т.ч. более правильно стал работать интерфейс из под IE 8.0). Еще одно востребованное улучшение – за счет новой прошивки XR3A для дисков Seagate (ST3500320NS, ST3750330NS, ST31000340NS) повышена производительность.

image image

Все прошивки находятся в открытом доступе на сайте производителя, однако надо помнить, что процедура обновления традиционно многоступенчатая и требует определенной внимательности и аккуратности.  Подробности можно найти в документации, но лучше обратиться в сервис, чтобы, как минимум, получить правильный совет и не “завалить” рабочую систему.

Читать дальше ...

вторник, 15 декабря 2009 г.

FCoE удобнее и компактнее

Строить FCoE уже давно можно – все для этого есть: и адаптеры в серверы, и коммутаторы. Наибольший интерес к FCoE можно ожидать при использовании Blade-решений, так как возможности по установке плат расширения зачастую ограничены. Но цена вопроса все еще довольно высока, особенно учитывая то, что для подключения дисковых систем в большинстве случаев требуется использовать не только 10Gbit коммутационные модули в шасси, но и FCoE коммутаторы с FC портами, либо строить отдельную FC инфраструктуру. Для того чтобы упростить ситуацию, IBM анонсировал для шасси BladeCenter H модули Virtual Fabric Extension. Этот модуль подключается через мид-плэйн к коммутатору BNT Virtual Fabric 10 Gb Switch и позволяет использовать FC порты без необходимости установки дополнительных FC HBA плат в сами лезвия:

В лезвия достаточно установить по одному двухпортовому CNA адаптеру Qlogic, а в шасси – различные по количествам вариации из 10Gb коммутаторов BNT и модулей Virtual Fabric Extension. В максимальной конфигурации поддерживается 2+2 модуля (как на рисунке выше); в минимальной - 1+1 (без отказоустойчивости и задействован только один порт на CNA); кроме того, возможен вариант, когда к двум 10Gb коммутаторам подключен только один модуль Virtual Fabric – это обеспечивает максимальное число внешних портов 10Гбит (16шт).

Virtual Fabric Extension Module может работать как в режиме Full Fabric, так и в режиме NPIV, что обеспечивает дополнительную гибкость конфигураций. Дополнительно хочется отметить, что все “высокоскоростные” прелести  доступны только в шасси BladeCenter H (или HT для телекома), поэтому именно это шасси и имеет смысл рассматривать если есть хоть малейшие перспективы для использования 10Gb.

Читать дальше ...

понедельник, 14 декабря 2009 г.

IBM SVC Entry Edition

Уже довольно давно IBM предлагает (и надо заметить небезуспешно) свою систему виртуализации СХД – SAN Volume Controller (SVC). Писать про SVC можно много, но сейчас не об этом. Так как внедрение системы виртуализации СХД это своего рода радикальное изменение в инфраструктуре (хотя оно и может быть реализовано практически полностью прозрачно), то решиться на этот шаг не всегда просто. Именно поэтому уже больше года, если не ошибаюсь, была выпущена версия “для неуверенных”, т.е. решение, которое имело ограниченный функционал, но зато гораздо более бюджетное. В отличие от старшего собрата Entry Edition лицензируется по числу жестких дисков которые входят в виртуализуемый объем. Ограничение на момент выпуска составляло не более 60 дисков для кластера SVC. С одной стороны, этого вполне достаточно, чтобы развернуться “в полный рост” с системой начального уровня и организовать репликацию на удаленную площадку, но любое сравнительно серьезное расширение требует перехода на полную версию SVC. Да, этот переход не требует покупки нового железа, но все равно “бьет” по карману.

С выпуском версии SVC 5.1 и нового поколения железной части (на базе серверов x3550M2) возможности Entry Edition существенным образом расширились – поддерживается уже до 250 дисков (а это вполне себе серьезная система получается). Но на этом приятные новости не закончились – теперь совершенно бесплатно доступна лицензия на FlashCopy! А это уже серьезное подспорье, например в развертывании системы резервного копирования, – в частности Exchange 2010 можно будет бэкапить только через VSS (а VSS, в свою очередь, замечательно интегрируется с FlashCopy посредством Tivoli Storage FlashCopy Manager). Единственное о чем следует помнить – не нужно перебарщивать с лицензиями на FlashCopy – они конечно в базе (с годом поддержки) бесплатны, но дополнительная поддержка стоит денег и, если известно, что снимки нужно делать не со всего объема, то на дальнейшей поддержке можно немного сэкономить.

image

Все эти изменения в SVC Entry Edition делают его приобретение весьма заманчивым. Особенно если в хозяйстве уже есть какая-то “старая” система хранения и хочется не только добавить еще одну систему, но и унифицировать управление.

Читать дальше ...

вторник, 8 декабря 2009 г.

Вам чай с сахаром или руки с мылом помоете?

Глупый вопрос, не правда ли? Особенно глупо звучит, если Вы вдруг пропустили начало 90х годов прошлого века в России. Зато сейчас заканчивается первое десятилетие уже этого века, а все чаще приходится слышать не менее странную фразу: “зачем бэкап делать, если я уже RAID настроил?”. И звучит это, к сожалению, чаще всего не в момент создания системы, а уже в тот момент, когда данные надо спасать, причем спасать далеко не традиционными способами. И чем дороже был куплен RAID-контроллер, тем больше возмущение – “Я потратил такие деньги на контроллер, я разве похож на Рокфеллера, чтобы еще и резервную копию делать?! Все пропало! Производители сговорились! Нет справедливости на свете! Ведь я купил контроллер как раз для того, чтобы защитить свои данные!” Как Вы понимаете, речь идет главным образом о “домашних” пользователях, но иногда и в малом бизнесе наблюдаются подобные проблемы.

И возмущение это могло бы быть справедливым, если бы только хоть один производитель RAID-контроллеров позиционировал свой продукт как замену резервному копированию. Так для чего же тогда нужен RAID? Может ли он обеспечить защиту данных? Ответ, как это обычно и бывает, не так однозначен: может, но только в некоторых случаях. В каких? Очень просто - RAID (кроме RAID-0) обеспечит доступность данных при выходе из строя одного или более (например, двух в случае RAID-6) дисков. Вот собственно и вся защита, которую теоретически может Вам обеспечить аппаратный или программный RAID. Не больше! Обратите внимание на слово “доступность” – именно это главная задача, т.е. целю является не защита данных вообще, а минимизация возможных простоев. А могут ли данные на RAID-массиве “пропасть”? Конечно могут! И вариантов здесь очень много, вот лишь несколько примеров:

  • Программная ошибка  - самый простой случай и никак не зависит от наличия RAID.
  • Ошибка пользователя – не менее редкий (а скорее более распространенный) вариант.
  • Поломка сразу двух дисков в RAID-5 (либо трех в RAID-6). Скажете, что это маловероятно? Вовсе нет – если используются диски большого объема, то вероятность повторного сбоя во время перестроения (rebuild) массива при выходе одного из дисков заметно возрастает. Кроме того, возможна банальная проблема с блоком питания, который просто “убьет” электронику в нескольких дисках.
  • “Накопившиеся” логические ошибки на массиве. Откуда они берутся? На аппаратных RAID-контроллерах обычно есть кэш, который может значительно увеличить производительность дисковой операций записи. Но если кэш на запись никак не защищен, то неожиданная перезагрузка системы приведет потере данных в кэше контроллера. Если эта перезагрузка произошла, когда данные просто “ждали” в кэше, то будет ошибка на уровне файловой системы. А вот если в момент перезагрузки данные из кэша уже записывались на диски, то часть данных может оказаться записанными, а часть – нет. И теперь уже ошибки есть не только на уровне файловой системы, но и на уровне самого RAID-массива, так как неизвестно какая часть страйпа записана, а какая –нет. Для “отлова” таких ошибок большинство производителей предлагают соответствующие процедуры (consistency check), но кто ими пользуется пока гром не грянул? Защитить себя от этих проблем можно и батарейкой (BBU), конденсаторами с флэш-памятью или отключением кэша на запись. Но первое стоит денег, а второе - производительности.
  • Кэш есть не только на контроллере, но и на самих дисках. И операции записи кэшируются и на самих дисках. Всегда рекомендуется этот кэш выключать, но для SATA дисков и слабеньких контроллеров это радикально снижает производительность дисковой подсистемы. И те, кто не желает получить медленную систему все-таки оставляют этот кэш включенным. Что может случиться? Правильно, как и несколькими строками выше, перезагрузка может повлечь за собой потерю данных в кэше. И даже если контроллер думает, что с массивом все нормально, но на самом диске данные будут записаны совсем не те, которые нужны. И если этот сбой произошел на блоке с четностью, то до тех пор пока с массивом все нормально, данные будут доступны, а как только этот блок будет использован для восстановления (после сбоя совсем другого диска), в восстановленных данных будет “мусор”.
  • Контроллер взаимодействует с дисками, которые могут “отвечать” на команды контроллера с различными задержками (например, когда диск пытается сделать remap сбойного сектора). И контроллер может не дождаться ответа и отправит диск “на покой”. А что будет если это уже второй диск в RAID5? Правильно – данным можно сказать “прощай”. Да, конечно, диски из списков совместимости такими проблемами страдают крайне редко, но вот часто ли домашний пользователь смотрит на эти пресловутые списки? К сожалению  нет, гораздо чаще голосование происходит либо рублем, либо в пользу “любимой” марки.

Выше я перечислил только самые распространенные случаи, все это может накладываться друг на друга и число потенциальных проблем вырастает как снежный ком. Если в момент какого-то из сбоев происходит еще и “рисковая” операция с массивом (например добавление диска в массив), то вероятность успешного восстановления данных “своими руками” (я уже даже не говорю про средства самого контроллера) стремительно приближается к нулю. Что мы, увы, очень часто наблюдаем (правда со стороны).

Так может быть, скажете Вы, RAID контроллеры это “зло” и средство для обогащения жадных производителей? Столько ужасов рассказано, может быть RAID дома и не нужен вовсе? Когда же имеет смысл его использовать?

  • Если нужно повысить скорость работы дисковой подсистемы (когда производительности одного диска мало). Если хобби это обработка видео или “игры” с виртуальными машинами, то почему бы и нет?
  • Компьютер – часть домашнего офиса и там хранится коммерчески важная информация. Вам ведь нужно обеспечить защиту данных до того, как будет сделана резервная копия.
  • Жалко времени на переустановку системы в случае выхода из строя диска. Вполне логично, особенно если компьютер это не полигон для испытаний и еженедельная переустановка Windows не входит в воскресное расписание.
  • Хранятся большие объемы данных в оперативном доступе и нет никакого желания восстанавливать их в случае сбоя диска.

О чем же нужно помнить, если решили упростить себе жизнь, используя RAID?

  1. Использование любого RAID, установка BBU, отключение кэшей, регулярные проверки – ничто не гарантирует сохранность данных, если нет проверенной резервной копии.
  2. Копии важных данных должны храниться на разных носителях и очень желательно, чтобы один из этих носителей не был бы доступен для записи.

А ниже несколько рекомендаций на случай, если все-таки хочется наплевать на все то, что было сказано выше, и сделать по-своему:

  1. Создавая RAID-массив, записывайте все настройки (порядок дисков, размер страйпа и т.п.). Записывайте даже если Вы просто приняли все предлагаемые значения. Фактическое значение этого самого “default” для разных версий прошивки (firmware) аппаратного контроллера может отличаться. Разумеется не нужно хранить эти данные в текстовом файле на самом массиве – не пожалейте листа бумаги.
  2. Поддерживайте актуальную версию прошивок и драйверов. Хотя и не нужно бросаться грудью на амбразуры и устанавливать новую прошивку в день ее выхода – если у Вас сейчас нет проблем, подождите с недельку-другую, может быть именно с ней возникнут проблемы и она будет вскоре заменена.
  3. Используйте все доступные средства мониторинга. Если о случившемся сбое Вы узнали не из сообщения об ошибке в почте, а из того что система уже не загружается, зачастую уже поздно бывает что-то спасать.
  4. Делайте регулярную проверку целостности данных.
  5. Сделайте копию хотя бы самых-самых важных данных, например на DVD диски.
  6. Если планируете что-то изменить в конфигурации массива (добавить диски, изменить уровень RAID и т.п.), перечитайте еще раз пункт №5 (а лучше все это сообщение). Если изменение прошло успешно, вспомните про пункт №1 и измените соответствующие записи.
  7. Для аппаратных контроллеров диски выбирайте не по цене или общему впечатлению о бренде, а из списков совместимости для данного контроллера.
  8. Если что-то сломалось, прежде всего скопируйте самые важные данные, а уже потом занимайтесь самолечением.
  9. Если сломалось все так, что данные уже недоступны, не делайте резких движений и обратитесь к профессионалам. Найти таковых не представляет особенных проблем – даже если Вы находитесь вдали от двух столиц, общение можно свести к пересылке по почте и телефонному общению. Поверьте, почтовые затраты померкнут на фоне стоимости работ по восстановлению. Если есть возможность, сделайте посекторную копию всех дисков и экспериментируйте уже “на кошках”.

Все это конечно не оградит Вас от потери данных, но поможет заметно снизить риск этих потерь и вполне возможно сделает чуть ниже стоимость работ по восстановлению (если все-таки час “Х” настанет). Еще раз: будьте готовы к тому, что для восстановления данных нужно будет обратиться в специализированные организации. И не удивляйтесь когда стоимость работ окажется в несколько раз выше цены дисков и контроллера вместе взятых. Если же такие траты Вам не по плечу, то задумайтесь еще раз о резервном копировании тех данных, которые не хотите терять. И мойте руки с мылом, а в чай кладите сахар.


Читать дальше ...

вторник, 24 ноября 2009 г.

Сколько должно быть разъемов на контроллере?

Наболело! Чуть ли не каждый день вижу вопросы такого плана: “В сервер можно поставить 16 (24) жестких диска, а SAS RAID контроллер у меня только 8-ми (или того хуже 4х) портовый! Что мне делать? Это наверное ошибка в конфигурации?!”. Ну что на это можно сказать? Может быть это конечно и ошибка, но скорее всего нет. Как же так? А все очень просто: SAS это протокол последовательной передачи данных и поддерживающий коммутацию. Если Вам нужно к серверу подключить 7 рабочих станций, Вы же не ставите в сервер 7 сетевых карт, а используете коммутатор на 8 портов, который позволяет всем машинам получить доступ к серверу. Точно также и в данной ситуации: либо в самом корпусе (прямо на бэкплейне), либо в виде отдельной карты присутствует аналог этого самого коммутатора. Только в данном случае он называется SAS-экспандером и позволяет подключить к RAID контроллеру гораздо больше дисков, чем есть SAS линий на самом контроллере. Наиболее распространены экспандеры на базе чипов LSI: LSISASx28, LSISASx36 или LSISAS2x36 (для 6Gbps SAS). В частности, на бэкплейнах в корпусах Supermicro используются экспандеры именно LSI. Отдельные карты с экспандерами также существуют, например в России проще всего найти их среди продукции компании Chenbro.

imageНа рисунке – возможная схема подключения с двумя RAID контроллерами для отказоустойчивости к дискам через экспандер. Правда, надо сказать что это довольно специфичная конфигурация, которую мы обычно наблюдаем во внешних дисковых системах, в серверах же используется более простая схема, в которой нет ни второго контроллера, ни второго экспандера.

Вот вроде бы и разобрались – для подключения 24х дисков вовсе не нужно 24 порта на контроллере, достаточно и 4х (так как обычно именно 4 SAS линии используется для соединения контроллера с экспандером). А используя контроллер с 4мя внутренними портами и 4мя внешними можно не только задействовать (при использовании экспандера все диски в сервере, но и обеспечить возможность дальнейшего увеличения дисковой подсистемы за счет добавления внешней дисковой полки (JBOD).

Но сразу возникает несколько новых вопросов: “А нужно ли использовать экспандер? Может быть он так замедляет работу, что от него надо отказаться? У меня целых 24 (а то и еще больше) диска подключено только по 4м линиям SAS – наверное это будет очень медленно?”.

Попробуем найти ответы. Начнем с конца: 4 SAS линии по 3Gbps дают в сумме 12Gbps, а это целых 1.5 Гига-байта в секунду. Можно ли реально достичь такой пропускной способности? В принципе можно, но (а) нужно помнить, что наверное с этим потоком нужно еще что-то делать, а не просто читать или писать и (б) дисков для этого потребуется (даже при благоприятном стечении обстоятельств) заметно больше десятка. А если учесть, что при типичной работе сервера запросы к дисковой подсистеме идут в значительной степени случайные, то полосы пропускания в 12Gbps оказывается вполне достаточно – можете проверить сами на любом своем сервере, запустив perfmon (под Windows) и посмотрев на трансфер с дисков во время работы. А что до возникновения дополнительных задержек при использовании экспандеров, то они конечно есть, но “поймать” (измерить) их Вам не удастся – настолько они малы по сравнению с задержками при обращении к жесткому диску. Есть и еще один аргумент, чтобы не бояться экспандеров – в RAID-контроллерах, где количество портов больше 8, зачастую это объясняется именно наличием интегрированного на плате экспандера – например Adaptec 51245, 51645, 52445. Так что по сути, делая выбор в пользу многопортового контроллера, Вы просто приобретаете SAS экспандер на одной плате с контроллером.

Итак, использование SAS экспандеров не только не противопоказано, а вполне оправдано в подавляющем большинстве случаев!

Читать дальше ...

среда, 18 ноября 2009 г.

HP Virtual Connect для чайников

HP выпустили книжку “HP Virtual Connect for Dummies” – на 76 страница кратко и понятно объясняются основные моменты построения коммутации для Blade-серверов HP. Первые 2500 зарегистрировавшихся могут скачать книжку бесплатно.

image

Читать дальше ...

понедельник, 16 ноября 2009 г.

Бесплатный сыр (софт) без мышеловки.

Не так давно VMware объявила о доступности VMware vCenter CapacityIQ – плагина для vCenter, который дает возможность анализировать нагрузку на серверы, а также делать прогноз в стиле “что если”. Плагин является платным, но (как и для других продуктов VMware) можно скачать 60ти дневный триал. Схожие продукты были и у других компаний, например, VKernel поставляла (также платный) Modeler. Но вот на днях было объявлено, что теперь (по крайней мере до 31 декабря 2009г) данный продукт доступен совершенно бесплатно на неограниченное число хостов. Возможностей у Capacity Modeler достаточно, чтобы удовлетворить самые разные требования. Так что если нужно планировать увеличение нагрузки за счет добавления новых виртуальных машин, а бюджета на CapacityIQ уже нет, то решение от VKernel будет очень кстати. Конечно же, данная акция рассчитана прежде всего на привлечение клиентов к более “вкусным” (но уже не бесплатным) продуктам VKernel, но никто не мешает Вам ограничится только бесплатной (и от этого ничуть не менее полезной) частью.

Читать дальше ...

понедельник, 9 ноября 2009 г.

Объединяй и властвуй!

Очень часто, говоря про блейд-серверы или про виртуализацию, я сталкиваюсь с тем что собеседники ошибочно воспринимают эти технологии как средство объединения ресурсов нескольких физических серверов в один большой. Тогда как на самом деле, блейд-серверы это всего лишь удобным образом упакованные в один корпус совершенно независимые машины. Виртуализация же серверов, в свою очередь, предназначена для консолидации нескольких задач (виртуальных машин) на одном физическом сервере:

image

А все дополнительные возможности (с красивыми названиями Live Migration, VMotion, DRS, HA и т.п.) служат для управления виртуальными машинами и их перемещением между серверами, но никак не для того, чтобы объединить ресурсы нескольких серверов для распределения между ними одной “тяжелой” задачи.

Хорошо, скажете Вы, а что делать, если стоит задача именно увеличить процессорную мощность системы по сравнению с имеющимся сервером? В большинстве случаев решением является приобретение сервера с большим числом процессоров. Но если задача реализована на x86 архитектуре и работала на двухпроцессорном сервере, то приобрести 4х процессорную машину можно без проблем. 8-ми процессорные системы тоже есть, но выбор гораздо меньше, а цена заметно выше. Ну а дальше? 32 процессора в одном сервере x86 уже фактически неразрешимая проблема – нужно переходить на другую архитектуру, что тоже не всегда возможно (да и требует более серьезных финансовых вложений). Для целого ряда задач решение есть – построение кластеров, где задача “распараллеливается” между серверами. Наиболее на слуху наверное Oracle Real Application Clusters (RAC) – несколько серверов объединяются для параллельной обработки запросов к СУБД, тем самым, увеличивается производительность системы. Другой, не менее часто встречающийся пример, – HPC (High-performance Computing), где вычислительная задача также разделяется на несколько подзадач, которые выполняются параллельно на нескольких вычислительных узлах. Оба эти примера объединяет одно – для работы требуется специальным образом оптимизированное приложение. В тех же случаях, когда такая оптимизация не была сделана, приложение работать либо вообще не будет (наиболее вероятный вариант), либо эффект от его запуска на кластере будет в лучшем случае нулевым. Кроме того, для успешной работы приложения необходимо приложить немало усилий к настройке самого кластера (например, в ряде случаев требуется наличие кластерной файловой системы, обеспечивающей параллельный доступ к данным с нескольких узлов).

Однако уже давно существуют способы объединить серверы через интерфейсы с низкой латентностью и высокой пропускной способностью (например Infiniband), а это, в свою очередь, открывает двери для протокола RMDA (Remote Direct Memory Access). RDMA позволяет приложению, исполняющемуся на одном сервере, получать доступ к оперативной памяти другого сервера, как если бы эта память была его собственная. Казалось бы, стоит сделать небольшой шаг и можно будет именно объединить ресурсы нескольких машин вместе, без необходимости в модернизации приложений и прочих сложностей, но до недавнего времени таких решений не было.

Но на днях мне попалась заметка со ссылкой сразу на двух производителей, которые “взяли быка за рога”: Scale MP и 3leaf Systems. Оба решения позволяют объединить несколько обычных серверов в один большой виртуальный SMP сервер, выполнение на котором приложений не требует их модификации для работы на кластере. Фактическая реализация очень похожа – для создания “объединительной” среды используется высокоскоростной интерфейс. 3leaf Systems используют свой собственный ASIC, который на текущий момент устанавливается в кастомизированные платы Supermicro для процессоров AMD, но в ближайшее время планируется решение и на процессорах Intel Xeon с поддержкой QPI. Dynamic Data Center Software позволяет выделять приложению ресурсы с гранулярностью на уровне отдельных узлов, либо на уровне процессорного ядра, а в скором времени обещают и динамическое выделение ресурсов без перезагрузки виртуальной машины. Уже сейчас можно использовать вместе до 16ти серверов (до 192 ядер) и суммарно до 1ТБ памяти.

Решение же от Scale MP может работать на самых разных системах, а для связи узлов друг с другом используется Infiniband. Серверы в рамках даже одного кластера могут отличаться друг от друга, наверное в т.ч. и из-за этого технология называется vSMP (v – versatile, универсальный).

imageОсновной продукт – vSMP Foundation for SMP является наиболее "продвинутым” вариантам и позволяет объединить до 255 ядер и 4ТБ памяти в один SMP сервер, поддерживается деление общего процессорного пула между виртуальными машинами (одна VM должна включать минимум два узла), для небольших конфигураций можно обойтись и без Infiniband коммутатора – узлы можно соединять друг с другом напрямую. Более бюджетный вариант vSMP Foundation for Cluster отличается от “старшего” брата ограничением памяти в 512ГБ и использованием процессоров не старше 2.4ГГц. vSMP Foundation for Cloud позволяет динамически вводить машины в общий пул –загрузка производится по сети (а не с флэшки, как в остальных вариантах). Очень интересной возможностью является использование различных конфигураций в рамках одного кластера: для приложений, крайне требовательных к объему памяти, но не столь требовательных к числу процессорных ядер, можно строить систему, в которой часть узлов с быстрыми процессорами предназначена непосредственно для исполнения приложения, а другая часть – со сравнительно медленными процессорами, но большим объемом памяти, используется только для увеличения общей оперативной памяти, выделяемой приложению (процессоры этих узлов не будут использоваться для работы пользовательского ПО):

image Конечно же, такое “объединение” ресурсов не является заменой failover кластеру – любая аппаратная проблема внутри такой системы приведет к полной остановке приложения и потребуется перезапуск системы. Возможность изоляции сбойного узла предотвращает длительный простой, но если требуется высокая доступность приложения, то помимо объединения ресурсов в “большой” SMP сервер, необходимо предусмотреть и такие способы резервирования как кластер высокой доступности.

С учетом того, что цены на Infiniband снижаются все сильнее и построение инфраструктуры уже практически эквивалентно стоимости FC SAN, описанные решения по построению больших SMP систем имеют довольно много шансов занять вполне заметную нишу. Причем, от чисто вычислительных задач интерес постепенно будет смещаться в сторону бизнес-приложений (СУБД и т.п.).

Читать дальше ...

вторник, 3 ноября 2009 г.

Еще один RAID контроллер для IBM System x

Вчера, в день анонсов, IBM объявил о доступности довольно простенького контроллера ServeRAID M1015. Это уже третья модель у IBM для 6Gbps SAS 2.0. Из возможностей – RAID1/0/10 и поддержка до 32х дисков SAS/SATA. После установки M1000 Advanced Feature Key появляются RAID5 и 50 и encryption. Контроллер построен на базе чипа LSI SAS2008 и, как я понимаю, не имеет прямого аналога в линейке LSI MegaRAID. Ни кэш-памяти, ни возможности поставить батарейку нет, так что применение довольно ограниченное, но как достойная замена BR10i вполне подойдет.

image

Заодно был выпущен и M5000 Advanced Feature Key для контроллеров M5014 и M5015 – после его установки появляется RAID 6 и 60, а также возможность использовать encryption.

Обновился также документ ServerRAID Adapter Quick Reference, в котором содержится информация по возможностям и совместимости контроллеров для серверов IBM System x.

Читать дальше ...

Еще немножко про Veeam

Я уже некоторое время назад писал про анонс Veeam Backup & Replication 4.0, теперь его можно совершенно спокойно скачать и попробовать (а те, кто уже купил и находится на поддержке – обновиться).

Кроме того, наткнулся на пару роликов про продукцию Veeam. Рекомендую посмотреть тем, кому лень читать – хотя и с прицелом в маркетинг, но довольно внятно рассказывается про возможности.


А тем, кто решил приобрести VMware vSphere Essentials (недорогой вариант на 3 двухпроцессорные машины), рекомендую обратить внимание на специальный бандл от Veeam – Veeam Essentials, в состав которого входят три продукта Backup & Replication, Reporter и Monitor и все это сразу на те же 6 сокетов. В результате, получается удобная в обращении инфраструктура и закрыты не только вопросы управления, но и резервного копирования.

Читать дальше ...